LOCAL TYPED DECISION
クラゲの表情を、手元のGPUだけで決める
文章を入れると、8つの表情から1つを選んで顔が変わります。文章は外部のAPIに送っていません。判断も画像も、この事務所のマシンの中だけで完結します。
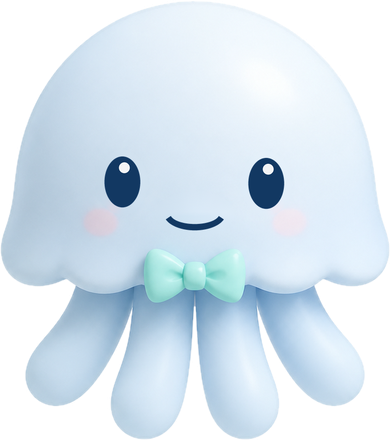
ふつう
何をしているか
ふつうの作り方は、文章を生成するAIに「本文の中に [joy] と書いてね」と頼み、出てきた文字列からタグを拾います。ところが小さいモデルはタグを書き忘れます。実際、この事務所の構成(gemma4)では5つの文すべてでタグが出ず、表情が一度も動いていませんでした。
ここでは文章を作らせず、8つの選択肢のどれがもっともらしいかだけを1回の計算で読みます。文字列に頼らないので書き忘れが起きず、発話の途中でも何度でも引き直せます。
実測
| 判断の速さ | 約110ms(RTX 3090・4bit)。同じことを対話モデルに聞くと660〜730msかかります |
|---|---|
| 正しさ | 用意した8表情ぶんの例文で 10/10 一致 |
| 外部通信 | なし。文章はこのマシンから出ません |
| 表情の絵 | 正規マスコット1枚から、目と口だけを描き換えて8枚。体は全表情で同一画素なので位置がずれません |
※ 確信度は「何%正しいか」ではありません。選択肢どうしの相対的な強さです。